

一、 概念与优势:ReAct 是如何工作的?
1、ReAct 的起源与定义
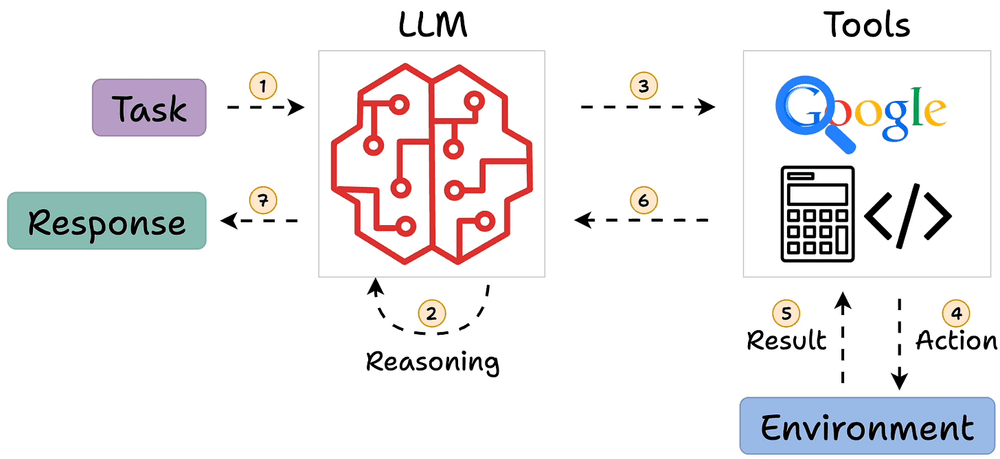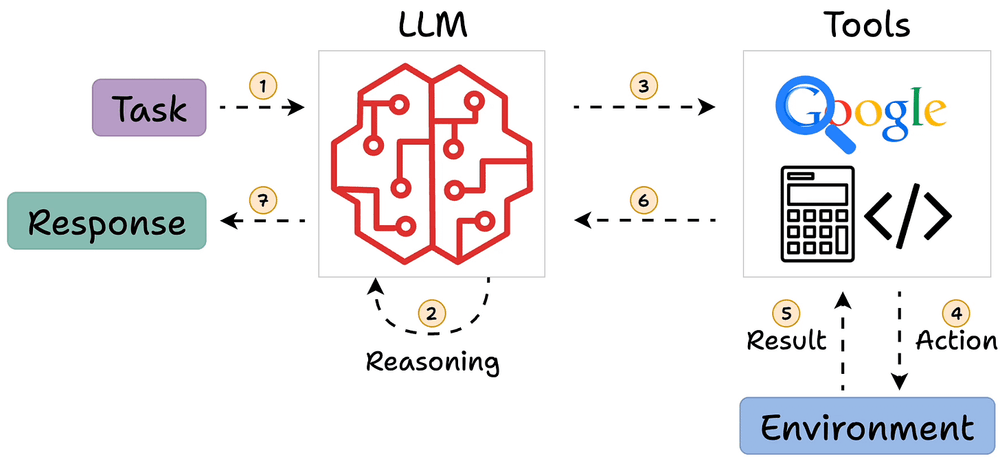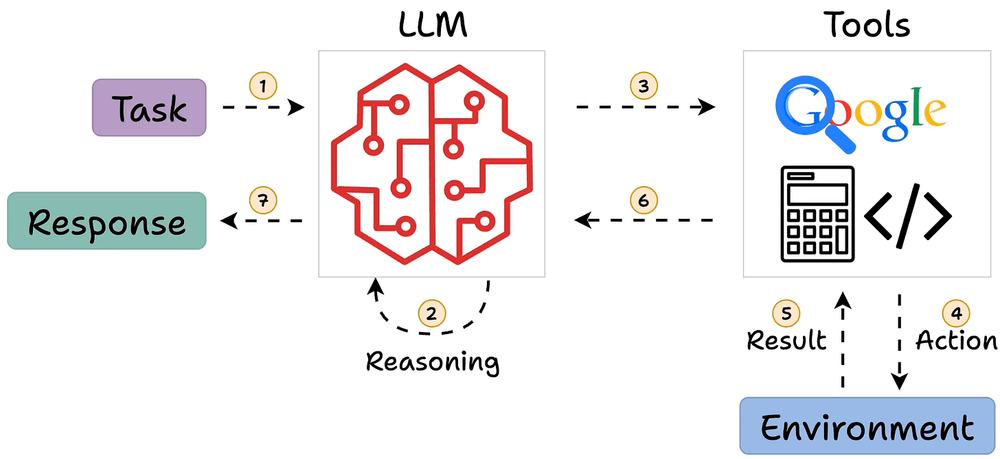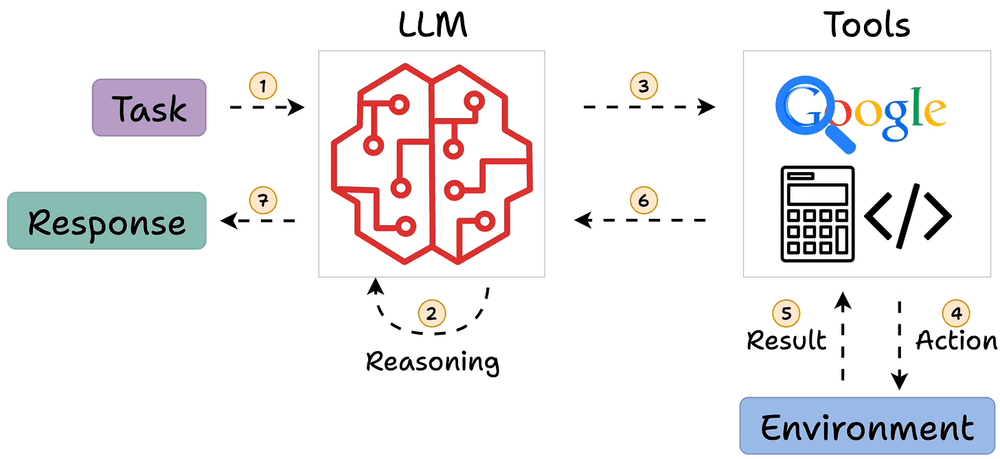
ReAct(Reasoning and Acting)最早由 Google Research 在 2022 年的论文中提出。这个名字听起来高大上,其实拆开看非常直白:推理(Reasoning)+ 行动(Acting)。 它的核心理念是让 AI 模型通过“一边想一边做”的循环来解决复杂问题,而不是像传统大模型那样“想完了再做”或仅凭内部记忆瞎猜。
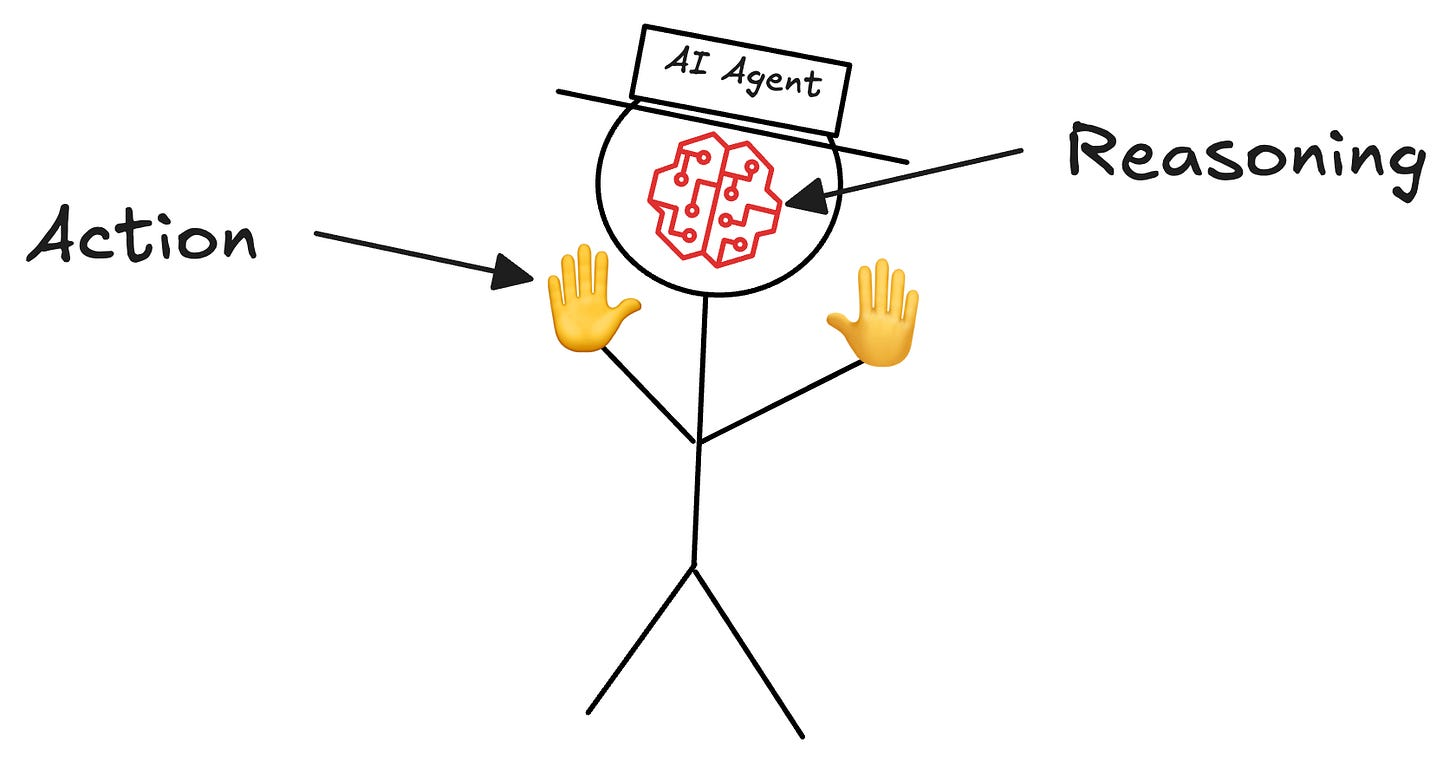
2、核心运转机制:T-A-O 循环
ReAct 的工作方式与人类解决问题的过程高度相似。它不会一次性规划好所有的死板流程,而是在有一个整体目标的前提下,走一步看一步,不断循环以下三个步骤:
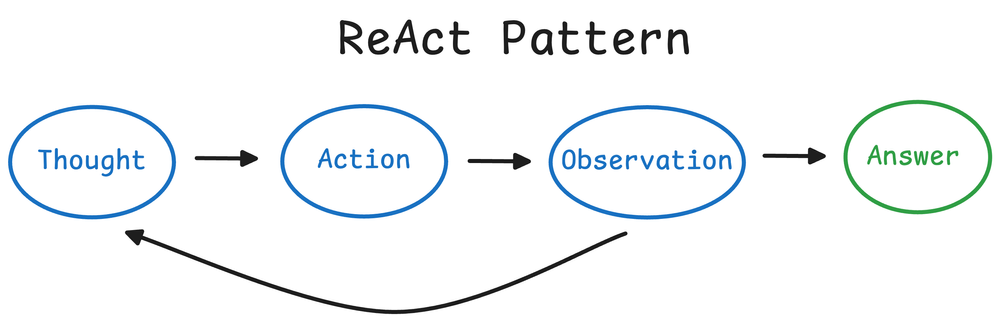
🤔思考 (Thought):Agent 的推理过程。理解当前问题、历史信息,并规划下一步行动。(例如:“我需要知道北京的天气,需要调用天气工具。”)
🛠️行动 (Action):基于思考结果,调用外部工具(如搜索引擎、计算器、API、本地文件操作等)。
👀观察 (Observation):获取工具执行后的返回结果。基于这个真实结果,Agent 再次进入“思考”环节。
ReAct Agent 的工作方式与人类解决复杂问题的过程高度相似。它不会在任务开始时就一次性规划好所有的死板流程,而是在有一个整体目标的前提下,采取“走一步看一步”的策略。
3、与传统方法的比较
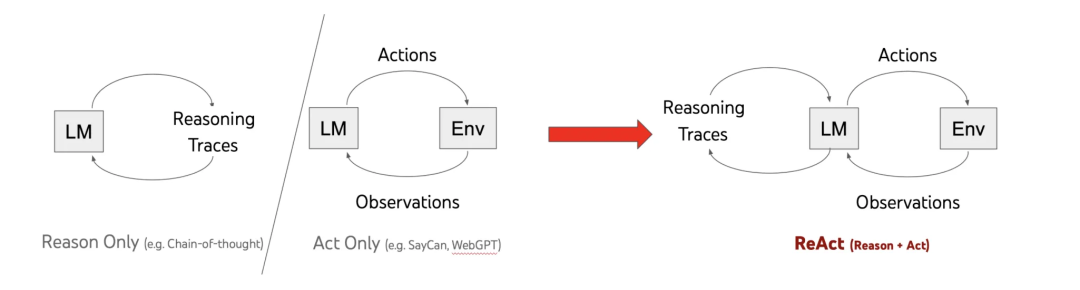
与仅推理(Reasoning-Only)或仅行动(Action-Only)的方法相比,ReAct 具有明显优势:
对比 Reasoning-Only:纯推理模型会基于任务进行逐步思考,但不管是否获得结果都会把思考步骤执行一遍,缺乏与外部世界的交互。
对比 Action-Only:纯行动模型处于完全没有规划的状态,先行动再观察,导致结果不可控。
ReAct 通过推理与行动的协同,实现了更接近人类问题解决方式的智能行为。
就像你要去一家没去过的咖啡店。走到路口,你观察一下路牌,思考后决定左转(行动);走了一段发现不对,再向路人询问(行动),获取新路线(观察),边走边找,最终到达目的地。
4、为什么我们需要 ReAct?
现实任务往往充满了不确定性(如 API 返回错误、数据格式异常、需要根据中间结果临时调整策略)。相比传统方式,ReAct 具备以下压倒性优势:
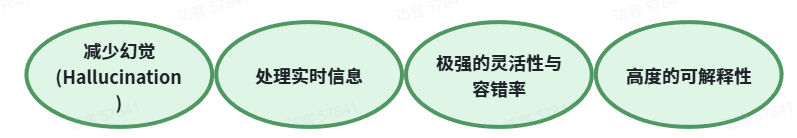
减少幻觉 (Hallucination):传统 LLM 容易“一本正经地胡说八道”。ReAct 赋予了模型“手脚”,通过调用外部工具获取真实、实时的信息,避免了仅凭内部知识回答的错误。
处理实时信息:能够随时获取最新数据,完美解决模型知识库更新不及时的问题。
极强的灵活性与容错率:遇到意外不会直接卡死。如果第一步搜索失败,Agent 会自己“思考”换一个搜索关键词,或者尝试调用其他工具。
高度的可解释性:通过显式的 Thought(思考)过程,开发者可以清晰地看到 Agent 是如何一步步推导出最终结果的,方便调试和优化。
⚠️提示:ReAct 的代价
这种灵活性并非没有成本。由于决策权交给了 AI,系统的行为可能变得不那么可预测,有时候 AI 可能会“犯傻”或绕弯路。但总体而言,在处理复杂、高不确定性的任务时,ReAct 这种“边想边做”的方式是目前最优的解法。
二、 实现 ReAct 的五大关键要素
要让 AI 具备 ReAct 的能力,底层离不开以下五个核心组件:
三、 案例推演:Prompt 构造与完整工作流
要让大模型按 ReAct 方式工作,关键在于设计一个合适的 Prompt 模板,并将其投入循环中。
1、通用 ReAct Prompt 模板设计
一个合格的 ReAct Prompt 必须包含:角色定义、可用工具、思考行动规则、示例(Few-Shot)、历史上下文与当前问题。
你是一个可以使用工具解决问题的智能助手。
【可用工具】
1. 天气查询工具:用于获取指定城市的天气。参数:城市名。
2. 穿衣建议知识库:根据天气情况获取穿衣建议。参数:天气状况。
3. writeToFile:将内容写入文件。参数:文件内容。
【思考与行动规则】
1. 你必须通过思考(Thought)、行动(Action)、观察(Observation)的循环来解决问题。
2. 首先分析问题,确定需要哪些信息,然后决定最少使用一个工具获取。
3. 当你认为已经完成了用户的最终目标时,输出最终结果。
已知上下文:
历史记忆:{history_context}
当前环境信息:{env_info}
用户目标:"{user_goal}"
请做出下一步的决策。
2、完整工作流推演:查天气并保存建议
用户目标:“帮我查一下北京今天天气怎么样,适合穿什么衣服,并保存下来。”
以下是系统底层的真实流转状态(多轮对话拆解):
四、 代码实战:从零手写一个 ReAct Agent
不依赖沉重的第三方框架(如 LangChain),我们完全可以用最原生的伪代码和 Python 逻辑来实现上述的循环。
1、核心大循环伪代码
# ---------------- 单个轮次逻辑 ----------------
def 执行一个轮次(用户目标, 历史上下文):
    # 1. 获取当前环境信息
    当前环境信息 = 获取当前环境信息()

    # 2. 构建提示词(注入当前的变量)
    提示词模板 = """已知:
                    当前历史上下文:{history}
                    当前环境信息:{env}
                    用户目标:"{goal}"
                    做出下一步的决策,你必须最少使用一个工具来实现该决策。"""

    完整提示词 = 替换占位符(提示词模板, history=历史上下文, env=当前环境信息, goal=用户目标)

    # 3. 调用大语言模型进行推理(思考过程隐藏,直接输出需要调用的 toolcall)
    工具调用结果 = 调用语言模型(完整提示词)

    # 4. 解析大模型想要调用的工具和参数
    工具名称 = 解析工具名称(工具调用结果)
    工具参数 = 解析工具参数(工具调用结果)

    # 5. 实际执行工具调用(Action)
    观察结果 = 执行工具(工具名称, 工具参数)

    # 6. 更新记忆(将本次操作和反馈存入上下文)
    新历史上下文 = 追加到历史上下文(历史上下文, 行动=工具调用结果, 观察=观察结果)

    # 7. 返回本轮结束后的状态
    return {
        "观察结果": 观察结果,
        "新历史上下文": 新历史上下文
    }
# ---------------- 主控循环逻辑 ----------------
def 执行ReAct流程(用户目标):
    历史上下文 = 空
    当前轮次 = 1
    最大轮次 = 10  # 防止死循环,设定最大重试/思考次数

    # 开始 "观察-思考-行动" 的循环
    while 当前轮次 <= 最大轮次 且 未完成任务:
        # 跑一轮
        结果 = 执行一个轮次(用户目标, 历史上下文)

        # 刷新记忆
        历史上下文 = 结果.新历史上下文

        # 判断大模型是否认为任务已经全部搞定
        if 判断任务已完成(结果.观察结果):
            print("任务圆满完成!")
            break  # 中断循环

        当前轮次 = 当前轮次 + 1

    return 历史上下文
2、Python 简易实现参考
下面提供一个精简且可运行的 Python 代码骨架,展示了如何解析大模型的输出并控制循环(基于硅基流动 API + 通义模型):
import re
from openai import OpenAI
class ReActAgent:
    def __init__(self, api_key: str):# 1. 初始化硅基流动客户端self.client = OpenAI(
            api_key=api_key,
            base_url="https://api.siliconflow.cn/v1"
        )# 2. 指定模型self.model_name = "Qwen/Qwen2.5-72B-Instruct"
        self.max_iterations = 8
        self.history =[]# 3.标准化 ReAct Prompt (严格约束输出格式)self.system_prompt = """你是一个具备 ReAct (Reasoning and Acting) 能力的智能助手。
                                你可以使用以下工具来解决用户的问题:
                                1. 【weather_search】: 查询指定城市的天气和气温。参数:城市名(如:上海)
                                2. 【calculator】: 执行数学计算。参数:数学表达式(如:25 - 18)

                                你必须严格按照以下格式输出(请一行一行输出):
                                Thought: 思考为了解决问题,我现在需要做什么
                                Action: 要使用的工具名称(必须是 weather_search 或 calculator,如果得出最终答案,请使用 finish)
                                Action Input: 工具所需的参数(如果是 finish,这里写最终给用户的完整回答)

                                注意:每次交互只需输出一次 Thought、Action 和 Action Input。不要自己编造 Observation,我会提供给你。"""

    def _weather_search(self, city: str) -> str:
        """天气查询工具实现"""
        mock_data = {
            "上海": "晴转多云,气温 18 到 25 度。",
            "北京": "大风,气温 10 到 15 度。"
        }
        return mock_data.get(city, f"暂无 {city} 的天气数据。")
    def _calculator(self, expression: str) -> str:
        """计算器工具实现"""
        try:
            # 注:生产环境中应使用安全的计算沙箱,避免 eval 注入风险
            return str(eval(expression))
        except Exception as e:
            return f"计算错误: {e}"
    def run(self, user_query: str) -> str:
        print(f"[Task Started] Query: {user_query}")
        print("-" * 50)

        self.history =[
            {"role": "system", "content": self.system_prompt},
            {"role": "user", "content": f"用户问题: {user_query}"}
        ]

        for step in range(1, self.max_iterations + 1):
            print(f"[Step {step}] LLM Reasoning...")# 1. 调用大模型进行推理response = self.client.chat.completions.create(
                model=self.model_name,
                messages=self.history,
                temperature=0.1
            )
            llm_content = response.choices[0].message.content.strip()
            print(f"{llm_content}\n")# 2. 将大模型的决定记录到上下文中self.history.append({"role": "assistant", "content": llm_content})# 3. 正则解析大模型的输出action_match = re.search(r"Action:\s*(.*)", llm_content)
            action_input_match = re.search(r"Action Input:\s*(.*)", llm_content)
            if not action_match or not action_input_match:
                observation = "格式解析失败,请确保包含 Thought/Action/Action Input 字段。"
                self.history.append({"role": "user", "content": f"Observation: {observation}"})
                continue
            action = action_match.group(1).strip()
            action_input = action_input_match.group(1).strip()# 4. 判断是否完成任务if action == "finish":
                print("[Task Completed]")
                return action_input# 5. 路由并执行对应的本地工具
            if action == "weather_search":
                observation = self._weather_search(action_input)
            elif action == "calculator":
                observation = self._calculator(action_input)
            else:
                observation = f"未知工具: {action}"
            print(f"[Observation] {observation}")
            print("-" * 50)

            self.history.append({"role": "user", "content": f"Observation: {observation}"})
        return "Task failed: Exceeded maximum iterations."
if __name__ == "__main__":
    API_KEY = "your_siliconflow_api_key_here"

    agent = ReActAgent(api_key=API_KEY)

    query = "请帮我查一下上海和北京今天的天气,并算一下他们今天的最高温度相差多少度?"
    answer = agent.run(query)

    print("\n[Final Answer]")
    print(answer)
五、 ReAct 的应用扩展与未来发展
ReAct 范式通过将“推理(Thought)”与“行动(Action)”解耦并循环迭代,使得 AI 真正具备了与现实世界打交道的能力。随着技术的演进,它正在从简单的脚本辅助走向更广阔的舞台。
1、核心适用场景
需要实时信息的任务:如天气查询、新闻获取、金融行情分析等。
依赖私有知识库的任务:如企业内部的文档问答、客服工单处理、垂直领域的法律/医疗咨询。
多步逻辑推理任务:如跨系统的旅行路线规划、复杂数学问题求解、长篇数据分析等。
与物理/数字环境交互的任务:如邮件自动收发、日程安排、智能家居控制、服务器运维(RPA)等。
2、功能扩展与进阶玩法
基于前文的基础版 Agent,在真实的生产环境中,我们通常会将其与其他高级范式结合,形成更强大的 AI 系统:
ReAct + Reflexion(自我反思):在执行报错或结果不佳时,触发反思机制,让 Agent 像人类一样评估自己的失败原因,并修改代码或策略重新尝试(Self-Correction)。
ReAct + Plan-and-Execute(全局规划):面对长线复杂任务,单一的 ReAct 容易“只见树木不见森林”。前置一个架构师角色负责拆解任务(Plan),再交由底层的 ReAct Agent 去逐个击破(Execute)。
ReAct + Tool Retrieval(动态工具检索):当系统拥有成百上千个工具时,每次都把工具说明写进 Prompt 会导致 Token 爆炸。通过引入向量库,让 Agent 先“检索”出最相关的工具,再进行调用。
3、ReAct 与 AI Agent 的未来发展
🚀站在当前的技术节点看向未来,基于 ReAct 范式的 AI Agent 正在向以下四个核心维度发生蜕变:
从 API 调用走向“系统级控制” (Computer Use)
现在的 Agent 主要依赖开发者预先写好的 API 接口(如查询天气的 Python 函数)。未来的 Agent 将具备直接接管操作系统的能力。它们可以像人类一样移动鼠标、点击屏幕图标、浏览网页 GUI。ReAct 的 Action 将直接变成系统级的键盘鼠标操作。
多模态的 T-A-O 循环 (Multi-modal Agent)
未来的“观察(Observation)”不再局限于文本。Agent 将能够直接“看”到屏幕画面的变化、“听”到环境的声音,并将这些多模态信息作为上下文,输入给大模型进行下一轮的“思考(Thought)”。
从单兵作战走向“多智能体协同” (Multi-Agent Swarm)
未来的复杂任务将不再由一个庞大的 Agent 独立完成,而是演变为一个智能体公司。例如:一个负责写代码的 ReAct Agent、一个负责审查报错的 ReAct Agent,以及一个负责查阅 API 文档的 Agent 相互对话、协同工作,从而爆发出群体智能。
端侧化与极速推理 (Edge Computing)
为了实现真正无缝的智能助理体验,Agent 的思考循环需要极低的延迟。未来,轻量级的大模型将被直接部署在手机、PC 和车机端。ReAct 循环将在本地设备上以毫秒级的速度闭环,甚至不需要连接云端网络,大幅保护隐私并提升响应速度。
评论区