

六、最麻烦的一点:Agent 每次运行的结果可能不一样
传统自动化测试比较简单。
比如:
assert result == expected
同样的代码跑 100 次,结果通常都一样。
但 LLM Agent 不一样。
即使下面这些条件完全相同:
Model
Prompt
Tool
Temperature
Agent 每次执行时,也可能走出不同的路径(Trajectory),最终结果自然也可能不同。
这意味着,我们不能看到某一次测试:
FAIL
就立刻认为新版有问题,甚至直接让 CI/CD 流程失败。
因为这次失败可能不是稳定存在的问题,而只是 Agent 随机性带来的一次波动。
Google 也特别强调了这一点:对于这类具有随机性的复杂 Agent 任务,不能过度依赖单次 Evaluation。更合理的方法是,同一个测试用例重复执行多次,然后观察整体通过率(Pass Rate)以及长期变化趋势。
例如,同一个测试跑 30 次:
results = []

for _ in range(30):
    trace = agent.run(test_case)
    result = evaluate_behavior(trace, test_case)
    results.append(result)
然后计算通过率:
pass_rate = (
    sum(r["passed"] for r in results)
    / len(results)
)
假设 V1 版本的结果是:
Behavior Pass Rate:96.7%
修改 System Prompt 以后,再跑同样的测试,V2 变成:
Behavior Pass Rate:76.7%
这时候就很有价值了。
因为你看到的不再是某一次偶然的 FAIL,而是通过率从 96.7% 明显下降到了 76.7%。
这就是一个非常明确的信号:
Prompt Regression
也就是修改 Prompt 以后,Agent 的整体表现发生了明显退化。
相比一句:
“感觉新版 Agent 好像变笨了。”
这种基于批量 Evaluation 得到的数据,显然更容易发现问题,也更适合用来判断一次 Prompt 修改到底是优化,还是退化。
七、Prompt Engineering,正在慢慢变成“测试工程”
再往前走一步,会出现一种很有意思的开发方式:
不再只是凭经验改 Prompt,而是“发现问题 → 加入测试 → 修改 Prompt → 跑测试验证”。
比如,我们在线上发现一个问题:
Agent 修改完代码以后,
经常忘记运行 pytest。
以前遇到这种情况,我们可能会直接改 System Prompt,加一句:
修改代码以后,记得运行测试。
然后试几次,感觉效果不错,就上线了。
但更可靠的做法是:
先把这个真实发生过的问题,加入 Evaluation Dataset,变成一个以后可以反复执行的测试用例。
例如:
async def test_agent_runs_tests_after_code_change():
    result = await agent.run(
        "修复 calculate_discount 函数的边界问题"
    )

    tools = extract_tools(result.trace)

    assert "edit_file" in tools
    assert "pytest" in tools
这个测试检查的重点很简单:
Agent 修改代码了吗?
修改以后有没有运行 pytest?
接下来再开始调整 Prompt。
第一版:
V1 Pass Rate:71%
修改 Prompt 以后:
V2 Pass Rate:89%
继续优化:
V3 Pass Rate:97%
这样我们就能用数据判断:
这次 Prompt 修改到底有没有效果?
而不是仅仅依靠“感觉好像聪明了一点”。
但做到这里还不够。
因为修好了一个问题,并不代表没有引入新的问题。
所以修改 Prompt 之后,还要把原来的 Evaluation Suite 全部重新跑一遍:
pytest evals/behavioral/
确认一个重要的事情:
新问题解决了,
原来正常的 Behavior 也没有发生 Regression。
这和传统软件开发其实非常像。
修一个 Bug,要先写测试;修改代码以后,不仅要确认这个 Bug 修好了,还要跑一遍回归测试,确保没有把其他功能弄坏。
只不过现在,被测试的对象从普通代码变成了 Agent,而被不断修改的对象,很可能是 System Prompt。
Google 甚至提到了更进一步的玩法:让模型自己修改 System Prompt,然后自动运行 Eval Suite。如果测试结果变好,而且没有破坏原来的行为,就保留这次修改;如果出现 Regression,就继续调整。
于是整个工作流逐渐变成:
发现 Bad Case
    ↓
加入 Evaluation Dataset
    ↓
修改 System Prompt
    ↓
批量运行 Eval
    ↓
比较 Pass Rate
    ↓
执行 Regression Test
    ↓
确认没有破坏其他 Behavior
这时候你会发现,事情已经发生了变化。
以前大家关注的是:
Prompt Engineering
核心问题是:
“Prompt 应该怎么写?”
现在则越来越接近:
Harness Engineering
也就是给 Agent 建立一整套可以反复运行、评估和验证的测试环境。
再往后发展,其实就是:
AI Testing Engineering
真正重要的能力,不只是“会写 Prompt”,而是能建立一套测试体系,用数据持续回答:
这次修改,真的让 Agent 变好了吗?
有没有在解决一个问题的同时,又制造出新的问题?
八、对传统测试开发工程师来说,这反而是一个新机会
看到这里你会发现,Agent 测试听起来很新,但背后的很多方法,其实和传统测试并没有那么大的区别。
以前测试开发工程师经常做这些事情:
pytest
API Testing
UI Automation
Mock
Assertion
Test Dataset
Regression Testing
CI/CD
Performance Testing
Observability
到了 Agent 时代,这些能力并没有过时。
更多时候,只是“测试对象”发生了变化。
现在我们开始测试:
Agent Evaluation
Behavioral Evaluation
Tool Calling Testing
MCP Testing
Evaluation Dataset
Trajectory Evaluation
Continuous Evaluation
Quality Gate
Agent Regression Testing
换句话说,以前我们测试的是:
接口对不对?
页面功能正不正常?
返回结果符不符合预期?
现在开始变成:
Agent 有没有完成任务?
有没有调用正确的工具?
工具参数传得对不对?
执行过程是否合理?
修改 Prompt 以后,能力有没有下降?
更换 Model 以后,有没有出现 Regression?
很多测试思路其实是一脉相承的。
比如传统 API 测试,我们可能会写:
assert response.status_code == 200检查接口有没有正常返回。
到了 Agent Tool 测试,可能会写:
assert "query_order" in tool_calls检查 Agent 在处理订单问题时,有没有调用正确的工具。
再比如,传统软件开发中的回归测试是:
代码修改
    ↓
运行 Regression Suite
    ↓
确认旧功能没有被破坏
Agent 的回归测试则变成:
Prompt / Model / Harness / Tool 修改
    ↓
运行 Evaluation Suite
    ↓
确认 Agent 原有能力没有退化
CI/CD 也是类似的。
传统 CI 可能是:
Test FAIL
    ↓
PR BLOCK
测试没通过,就不允许代码合并。
到了 Agent 时代,可以变成:
Evaluation 出现明显 Regression
    ↓
PR BLOCK
比如一个 PR 修改了 System Prompt,结果 Evaluation Pass Rate 从 95% 降到了 78%。
那么这个 PR 就不应该直接合并。
所以,传统测试和 Agent Evaluation 并不是两套完全割裂的东西。
更准确地说,是很多我们熟悉的测试思想,正在被迁移到新的测试对象上:
以前测试 Software
现在测试 Agent
测试开发工程师原来积累的很多能力——测试用例设计、自动化测试、Mock、数据集构造、回归测试、CI/CD、质量门禁、监控和可观测性——依然有价值,而且可以比较自然地迁移到 Agent Evaluation 领域。
真正需要补充的,是对 LLM、Tool Calling、MCP、Trajectory、Evaluation 等新概念的理解。
因此,对传统测试开发工程师来说,Agent 时代不一定意味着“以前学的东西没用了”。
更可能意味着:
原来的测试工程能力
        +
Agent / LLM 相关知识
        ↓
Agent Evaluation / AI Testing
测试对象变了,但很多测试工程的基本功,依然是相通的。
九、而且,这个趋势已经真正进入 CI/CD 了
这并不是为了文章效果,强行把话题拔高。
9 月 8 日,AWS 刚刚公开了一套完整实践:把 Automated Agent Evaluation(自动化 Agent 评估)直接接入 GitHub Actions。
整个流程其实很好理解:
Agent 修改
↓
部署到测试环境
↓
运行 Evaluation Dataset(评估数据集)
↓
采集 Agent Trace(执行轨迹)
↓
通过 AgentCore Evaluations 自动评分
↓
检查分数是否达到 Threshold(最低标准)
↓
未达标,GitHub Actions 直接 FAIL
↓
阻止 PR 合并
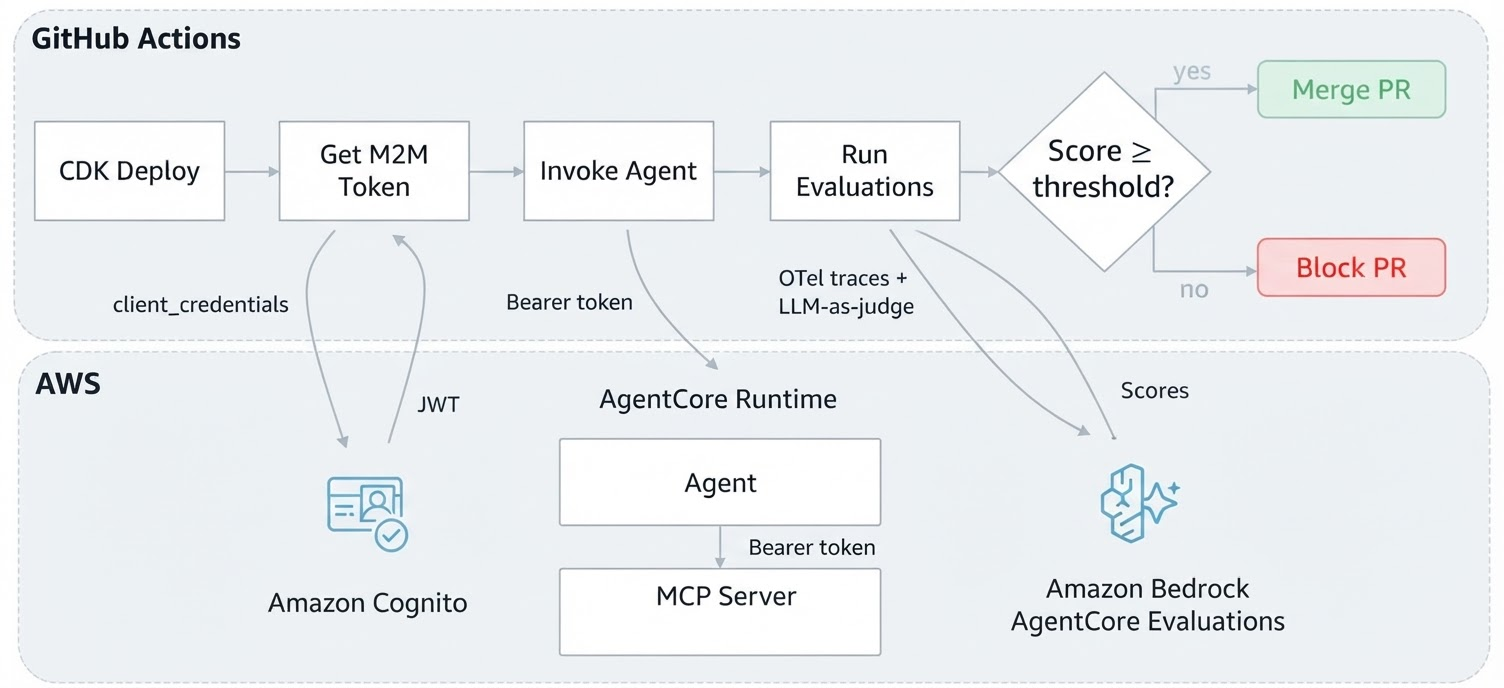
说白了,就是给 AI Agent 也加了一道“上线考试”。
以前我们做 CI/CD,会自动跑单元测试、集成测试。代码测试不过,就不能合并、不能上线。
现在 Agent 也是一样:你改了 Prompt、模型、工作流或者 Tool 之后,系统会自动跑一批测试任务,看 Agent 到底表现得怎么样。只要评分低于设定标准,这次修改就不能通过。
AWS 把这套机制明确称为 CI/CD Quality Gate,也就是 CI/CD 流程里的“质量门禁”。而且它展示的案例并不只是简单问答,还涉及带角色和权限控制的 MCP Tool。
这背后其实说明了一个很重要的变化:
以前我们更多讲 Continuous Testing(持续测试),关注的是“代码有没有问题”。
现在开始出现 Continuous Evaluation(持续评估),还要持续判断“Agent 表现得够不够好”。
未来,这两套机制很可能会逐渐融合:代码要过测试,Agent 也要过评估,只有两边都达标,才能真正进入生产环境。
而这,也正是下一篇我们要继续讨论的内容。
十、测试工程师真正值得补的,不是“会不会调用大模型 API”
如果只是会写一句:
response = client.chat(...)
其实已经算不上什么高门槛能力了。
现在很多大模型平台都提供了现成的 SDK 和示例代码,看几分钟文档,基本就能把 API 调起来。
真正能拉开差距的,是你能不能把 AI 的测试和评估做成一套完整、可重复、可自动化的工程流程。
比如:
准备评估数据集
↓
运行 Agent
↓
记录完整 Trace
↓
检查关键行为
↓
使用 LLM Judge 评分
↓
进行回归对比
↓
判断是否达到质量标准
↓
接入 CI/CD
更重要的是,你还要把 Agent 的表现变成一组真正可以量化、可以持续观察的指标,例如:
回答正确率怎么样
Tool 有没有选对、调用对
有没有遵守业务规则
执行路径 Trajectory 是否合理
响应速度 Latency 是否达标
Token 消耗了多少
每次运行 Cost 是多少
多次执行结果是否足够稳定
做到这一步,测试就不再只是“感觉这个 Agent 好像还不错”,而是可以用数据回答:这个版本到底有没有变好?改了一段 Prompt 会不会导致其他能力下降?换了一个模型之后,效果提升了多少、成本又增加了多少?这次修改到底能不能上线?
所以,测试工程师真正值得补的能力,不只是“会用 AI”,更不只是:
“让 AI 帮我生成几个测试用例。”
而是学会怎么测试 AI、评估 AI,并把整个过程工程化、自动化,最终接入研发流程。
做到这里,才算真正开始进入 AI 测试开发。
写在最后
Google 这次关于 Harness Engineering 的分享,我觉得真正值得测试工程师关注的,并不是行业里又冒出了一个新概念。
更值得注意的是它背后的趋势:
AI Agent 越来越接近真实业务、越来越多地进入生产环境之后,我们会发现,传统软件测试里的很多方法不仅没有过时,反而变得更重要了。
过去,我们主要测试的是:
接口
页面
服务
数据库
而现在,测试对象正在不断增加:
Agent
Harness
Tool
MCP
Context
Trajectory
看起来技术变了、名词变了、测试对象也变了,但测试真正要解决的问题,其实一直没变:
它有没有按照我们的预期工作?
改了 Prompt、模型、Tool 或代码之后,效果有没有变差?
遇到异常、超时或者工具调用失败时,它能不能正确处理和恢复?
这些问题,能不能在上线之前就被发现,而不是等用户来发现?
所以,从传统软件测试走到 AI Agent 测试,并不是过去积累的测试经验突然没用了。
恰恰相反,很多我们熟悉的测试思想——自动化测试、回归测试、异常测试、质量门禁、CI/CD——正在以新的方式重新出现在 AI Agent 领域。
测试要解决的核心问题没有变。
真正发生变化的,只是这一次,我们开始测试 AI 了。
评论区