

最近在做 AI Agent 的团队,可能都碰到过这种情况:模型没变,业务没变。
只是改了 System Prompt,调整了 Tool Schema,或者给 Coding Agent 新增了一个工具。
结果重新跑 Benchmark,一看:成功率反而下降了。
这时候最麻烦的问题来了:到底是哪儿出了问题?
是模型推理能力变差了?还是工具选错了?参数传错了?又或者代码虽然写完了,但 Agent 根本没去跑测试?
过去遇到这类问题,很多团队只能靠人工排查。重新翻 Prompt、日志、Trace、Tool Calling 记录,一条一条看,一步一步找问题,既费时间,也很难快速定位原因。
而 Google 最近公开的一篇关于 Harness Engineering 的技术文章,讨论的正是这个问题。
Google 提出了一个很值得测试工程师关注的思路:测试 AI Agent,不能只看最后“答对了没有”,还要看它中间“是怎么做的”。
比如,它有没有调用正确的工具?参数有没有传对?该执行测试的时候有没有执行?整个操作流程有没有按照预期进行?
这些发生在 Agent 执行过程中的行为,只要能够被观察、被判断、被重复验证,就应该成为测试的一部分。
这就是 Behavioral Evaluation,也就是“行为评估”。
它背后反映出的变化其实更加重要:AI Agent 正在越来越像一个真正的软件系统。
过去测试大模型,更多是给它一套题,然后看最终得分;但测试 AI Agent,只看结果已经不够了。我们还需要像测试软件一样,检查它的执行过程、工具调用和关键行为,并且通过持续回归测试,及时发现一次 Prompt 或工具调整到底“改坏了什么”。
一、以前我们是怎么测 Agent 的?
现在很多 AI 团队做 Agent Evaluation(智能体评测)时,第一个想到的通常还是:找一个 Benchmark 跑分。
比如在 AI Coding 领域,常见的有 SWE-bench、Terminal-Bench,以及公司内部自己整理的 Evaluation Dataset。
测试方法也很直接:
给 Agent 一个任务
↓
Agent 自己执行
↓
拿到最终结果
↓
运行测试
↓
判断 PASS / FAIL
↓
统计成功率
假设有 100 个测试任务,结果是:
Agent V1:82% 通过率
Agent V2:86% 通过率
乍一看很简单:V2 比 V1 强,因为成功率提高了 4%。
但 Google 提出了一个很关键的问题:86% 为什么会比 82% 高?到底是哪里变好了?
反过来也是一样。假设升级之后:
Agent V3:79% 通过率
我们只知道它变差了,却不知道为什么变差。
是模型能力退化了?还是 Prompt 改坏了?或者是 Harness(负责给 Agent 提供工具、环境和执行流程的基础设施)某个地方改出了问题?
Google 在 9 月 9 日发布的 Harness Engineering 相关文章中就提到:端到端 Benchmark 很适合判断 Agent “整体表现怎么样”,但当分数发生变化时,它很难告诉你“问题到底出在哪里”。
例如,你很难只从一个 79% 的成功率判断:
Agent 是不是遇到模糊的 Prompt 时过度自信了?
Agent 是不是写完代码后忘了运行测试?
Agent 是不是“幻觉”出了一个根本不存在的 CLI 参数?
还是某个工具调用或执行流程出了问题?
这其实和传统软件测试非常像。
以前测试一个软件,我们不会只做:
System Test(系统测试)
还会拆成:
Unit Test(单元测试)
Integration Test(集成测试)
Regression Test(回归测试)
因为只看“整个系统最终能不能跑通”,只能告诉你结果对不对,却很难告诉你问题出在哪。
Agent 也是一样。
只盯着 Benchmark 最后的 PASS / FAIL,就像只做系统测试。
它能告诉你 Agent 是变强了还是变弱了,但想真正把 Agent 做好,还需要进一步拆开看:它到底在哪一步做对了,又在哪一步出了问题。
二、谷歌给 AI Agent 当“监工”:不看嘴甜不甜,只看干活规不规范!
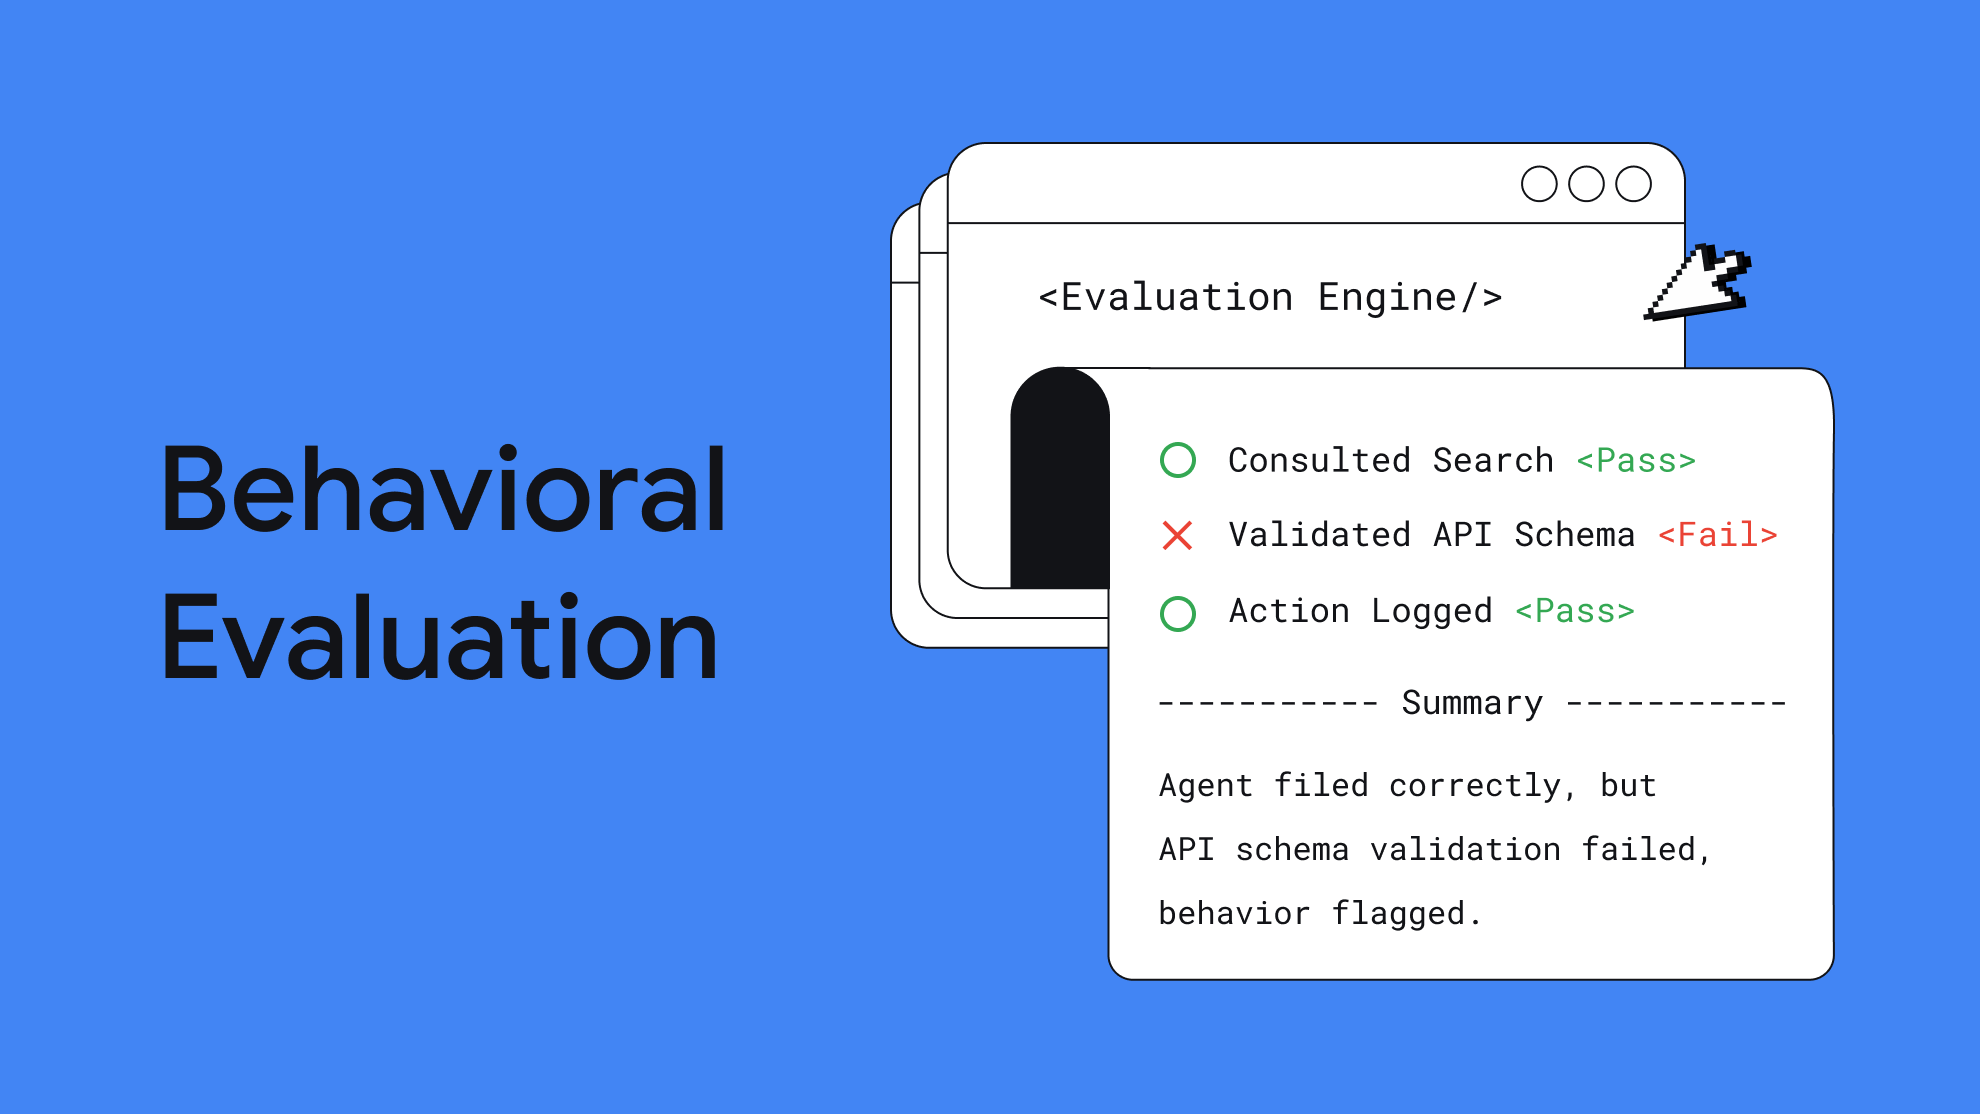
Google提出了一个概念,叫做 Behavioral Evaluation(行为评估)。
这个名字听起来有点复杂,但理解起来很简单:它有点像给 Agent 做“集成测试”。
重点不是看 Agent 最后回答得漂不漂亮,而是看它在完成任务的过程中,有没有做该做的事情。
比如,用户提供的信息不完整时,Agent 应该怎么处理?
是主动追问,把缺失的信息补全?还是不管三七二十一,自己猜一个答案?
再比如:
Agent 修改了 Build 文件后,有没有运行 Validator 做检查?
Agent 完成代码修改后,有没有调用测试工具?
Agent 生成文档时,引用的是不是正确的 Repository?
这些检查关注的都不是“最终答案长什么样”,而是 Agent 的“做事过程”是否正确。
这和过去测试 AI 的方式有一个很大的区别。
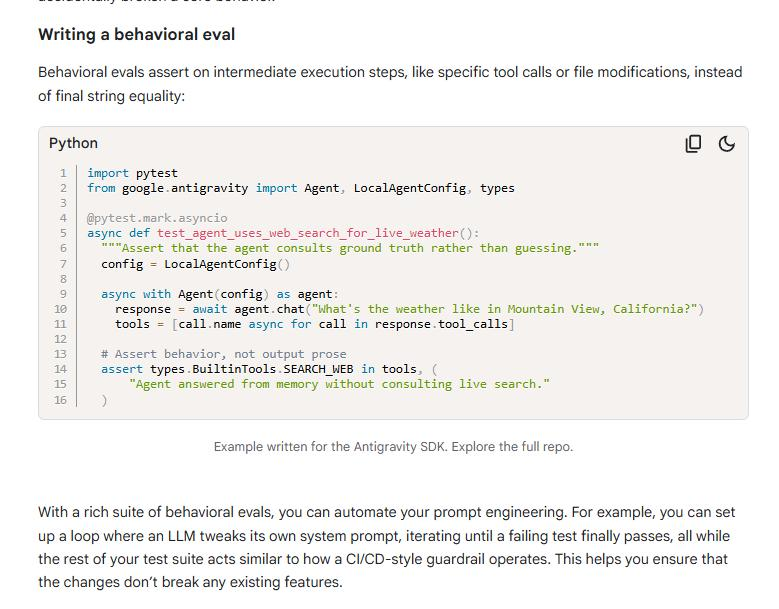
以前,我们可能更关注:
assert response == expected_answer
也就是:Agent 给出的答案,是不是和预期答案一致。
但现在,还需要检查:
assert agent.called_tool("test_runner")
也就是:Agent 在执行任务的过程中,有没有调用应该调用的工具、完成应该完成的步骤。
为什么这一点很重要?
因为“结果正确”和“过程正确”其实是两回事。
一个 Agent 可能这次碰巧猜对了答案,但它没有按照正确的流程执行。这样的 Agent,在真实业务里并不可靠。
所以 Behavioral Evaluation 真正想解决的问题是:不只要看 Agent “答对没有”,还要看它“是不是用正确的方式把事情做对了”。
换句话说:结果对了,不代表行为就对了;真正可靠的 Agent,既要把结果做对,也要把过程走对。
三、放到真实业务里,就更容易理解了
我们用一个电商售后的例子来看。
假设用户对 Agent 说:
“刚买的耳机还没发货,不想要了,帮我退掉。”
Agent 很快回复:
“好的,退款申请已经为您提交。”
只看最终结果,好像没什么问题,这条测试似乎可以直接判定:
PASS
但如果我们把 Agent 的实际执行过程,也就是 Trace 打开,就会发现它是这么做的:
用户请求
  ↓
查询订单 query_order
  ↓
直接退款 refund_payment
  ↓
回复用户
问题来了:它少了一个很关键的步骤:
check_refund_policy
也就是,它没有先检查退款规则。
甚至它可能都没有完整确认:
订单现在到底是什么状态?
用户是否已经支付?
这笔订单是否符合退款条件?
虽然这一次退款成功了,最终结果也是对的,但这很可能只是“碰巧做对了”。
换一个订单、换一种商品,或者换一个退款规则,它就可能直接出问题。
所以,测试 Agent 不能只看一句“退款成功”,然后就判定 PASS。
还要继续检查:
它查订单了吗?
它检查退款规则了吗?
它确认退款资格了吗?
它调用工具的顺序对吗?
这就是 Behavioral Evaluation 的价值。
它关注的不只是:
“最后事情办成了吗?”
还会进一步检查:
“Agent 是不是按照正确的流程把事情办成的?”
对于真正要上线的 Agent 来说,“碰巧正确”远远不够。我们需要的是:不仅结果正确,执行过程也正确。
四、给 AI 助手装个“合规监控”:行为评估 (Behavioral Evaluation)
评估 Agent 时,不能只看它最后回答得对不对,还要看它“中间是怎么做的”。
比如用户说:
“订单还没有发货,帮我退款。”
我们可以先定义一个测试 Case:
case = {
    "input": "订单还没有发货,帮我退款",
    "must_call": ["query_order", "check_refund_policy"],
    "forbidden_before_validation": ["refund_payment"],
    "max_steps": 8
}
这里其实是在告诉评测系统几件事:
Agent 必须先查询订单,并检查退款规则;
在完成必要验证之前,不能直接调用退款工具;
整个任务最好不要超过 8 个步骤。
接下来执行 Agent:
trace = agent.run(case["input"])
但这里有一个关键点:不要只看 Agent 最后的回答,还要检查它完整的执行轨迹(Trace)。
比如把它调用过的工具都取出来:
def get_tool_calls(trace):
    return [
        event.tool
        for event in trace
        if event.type == "tool_call"
    ]
然后对这些执行过程做“行为断言”(Behavior Assertion):
def evaluate_behavior(trace, case):
    tools = get_tool_calls(trace)

    missing_tools = [
        tool
        for tool in case["must_call"]
        if tool not in tools
    ]

    return {
        "missing_tools": missing_tools,
        "steps": len(trace),
        "passed": (
            len(missing_tools) == 0
            and len(trace) <= case["max_steps"]
        )
    }
这样一来,我们评估的就不只是“任务最后有没有完成”,还可以进一步判断:该调用的工具有没有调用、调用顺序对不对、必要的验证有没有做、执行步骤是不是过多,以及有没有在条件不满足时提前执行危险操作。
最终的 Evaluation 报告可能会变成:
Final Answer:PASS
Business Result:PASS
Tool Selection:PASS
Tool Sequence:FAIL
Required Validation:FAIL
Steps:5
Overall:FAIL
这个结果很有意思:虽然 Agent 最后确实把退款处理好了,答案看起来也没问题,但它没有按照正确流程执行。例如,它可能还没检查退款规则,就直接调用了退款接口。
所以,相比只告诉我们:
成功率:86%
这种行为评估更有价值。
因为“成功率 86%”只能告诉我们 Agent 大概表现怎么样;而 Behavioral Evaluation 能进一步告诉我们:Agent 到底错在哪里,是工具选错了、顺序错了、漏掉必要验证,还是执行过程太冗长。
对于真正要上线的 Agent 来说,“结果正确”很重要,“过程正确、可控”同样重要。
五、为什么这件事和 Harness 关系这么大?
最近 AI Agent 领域有一个很火的词:Agent Harness。
这个词看起来有点抽象,其实可以简单理解成:模型是“大脑”,Harness 就是围绕这个大脑搭起来的一整套“工作系统”,负责让模型真正把事情做起来。
比如,一个 Agent 要完成任务,光有模型还不够。它还需要知道自己该扮演什么角色、记住哪些信息、什么时候调用工具、任务失败后要不要重试、复杂任务怎么拆分,以及代码应该在哪里安全执行。
这些能力背后,通常会涉及:
System Prompt
Context
Memory
Tools
MCP
Skills
Subagent
Retry
Planning
Session
Sandbox
Execution Loop
...
这些东西组合起来,可以统称为 Agent 的 Harness。
所以,现在评价一个 Agent 的能力,已经不能简单地认为:
Agent 能力 = Model 能力
更接近真实情况的是:
Agent 能力
=
Model
×
Harness
×
Context
×
Tool
×
Runtime Configuration
也就是说,同一个模型,放到不同的 Harness 里,最终表现可能差很多。
比如,同样是让 Agent 修一个 Bug:一个只能读代码然后给建议;另一个可以自己搜索项目、修改代码、运行测试、发现失败、分析日志、重新修改,再跑一遍测试。
它们用的可能是同一个模型,但最终效果完全不同。
这也是为什么最近半年,Harness Engineering 越来越值得测试开发工程师关注。
因为 Harness 越复杂,需要验证的东西就越多:上下文有没有传对?工具有没有调对?失败重试是否合理?多 Agent 协作会不会出错?Sandbox 是否安全?执行循环会不会卡死?
换句话说:过去我们主要测试“软件功能是否正确”,现在还要开始测试“Agent 到底能不能稳定、正确地把事情做完”。
而这恰恰是测试开发工程师非常熟悉,也非常有机会发挥价值的地方。
评论区